Kubernetes as a Service
Stellen Sie Ihre containerisierten Anwendungen sofort bereit, skalieren und verwalten Sie sie
Kubernetes-Plattform auf Enterprise-Niveau
Cloud Acropolis Kubernetes as a Service bietet eine produktionsreife Container-Plattform, mit der Sie Ihre containerisierten Anwendungen mühelos bereitstellen, skalieren und verwalten können. Auf Basis branchenführender Technologien und Best Practices gewährleistet unsere Plattform 99,99 % Infrastrukturverfügbarkeit und vereinfacht zugleich Ihren Container-Betrieb.
Kube-DC-Cloud-Pakete
Dedizierte vCPU, Ceph-basierter NVMe-Speicher, eine dedizierte öffentliche IPv4-Adresse und verschachtelte Kubernetes-Cluster in jedem Paket. Wählen Sie eine längere Laufzeit, um den Monatspreis zu senken.
Dev Pool
Für Entwicklung und Tests
- 4 dedizierte vCPU
- 8 GB RAM
- 60 GB NVMe-Speicher
- 20 GB Objektspeicher
- 1 dedizierte öffentliche IPv4
Pro Pool
- 8 dedizierte vCPU
- 24 GB RAM
- 160 GB NVMe-Speicher
- 100 GB Objektspeicher
- 1 dedizierte öffentliche IPv4
Scale Pool
- 16 dedizierte vCPU
- 56 GB RAM
- 320 GB NVMe-Speicher
- 500 GB Objektspeicher
- 3 dedizierte öffentliche IPv4
Dev Pool + GPU
- 4 dedizierte vCPU
- 8 GB RAM
- 60 GB NVMe-Speicher
- 20 GB Objektspeicher
- 1 dedizierte öffentliche IPv4
- 25% geteilte NVIDIA V100 (8 GB VRAM)
Pro Pool + GPU
- 8 dedizierte vCPU
- 24 GB RAM
- 160 GB NVMe-Speicher
- 100 GB Objektspeicher
- 1 dedizierte öffentliche IPv4
- 50% geteilte NVIDIA V100 (16 GB VRAM)
Scale Pool + GPU
- 16 dedizierte vCPU
- 56 GB RAM
- 320 GB NVMe-Speicher
- 500 GB Objektspeicher
- 3 dedizierte öffentliche IPv4
- 100% geteilte NVIDIA V100 (32 GB VRAM)
Geteilte GPU: Der Speicheranteil wird pro Workload durchgesetzt; der Rechenanteil beruht auf Kooperation und ist weder eine Leistungsgarantie noch eine Sicherheitsgrenze. Die geteilte GPU ist für Container gedacht und kann nicht an virtuelle Maschinen angebunden werden.
In jedem Paket enthalten: verschachtelte Kubernetes-Cluster (KubeVirt), unbegrenzte Bandbreite von 1 Gbit/s, Ceph-Speicher auf NVMe sowie 24/7-Support per E-Mail und Ticket mit einer MTTR von 4 Stunden. Die Preise verstehen sich in Euro pro Monat.
Standardmäßig automatisiert
Kube-DC automatisiert Observability, HTTPS, Zertifikatsausstellung, Backups und Service-Lifecycle-Vorgänge, damit Sie Ihre Zeit in Anwendungen statt in Infrastruktur investieren.
Eine Service-Ebene
Ein Richtlinienmodell, ein Quotensystem und eine Nutzungsansicht für Cluster, virtuelle Maschinen, Speicher und GPU. Arbeiten Sie über die Weboberfläche, die API oder kubectl.
Worker-Pools
Erstellen Sie einen Managed Cluster und dimensionieren Sie jeden Worker-Pool nach CPU, Arbeitsspeicher und Festplatte. Die Control Planes werden für Sie gehostet, und Upgrades bleiben unter Ihrer Kontrolle.
Autoscaling
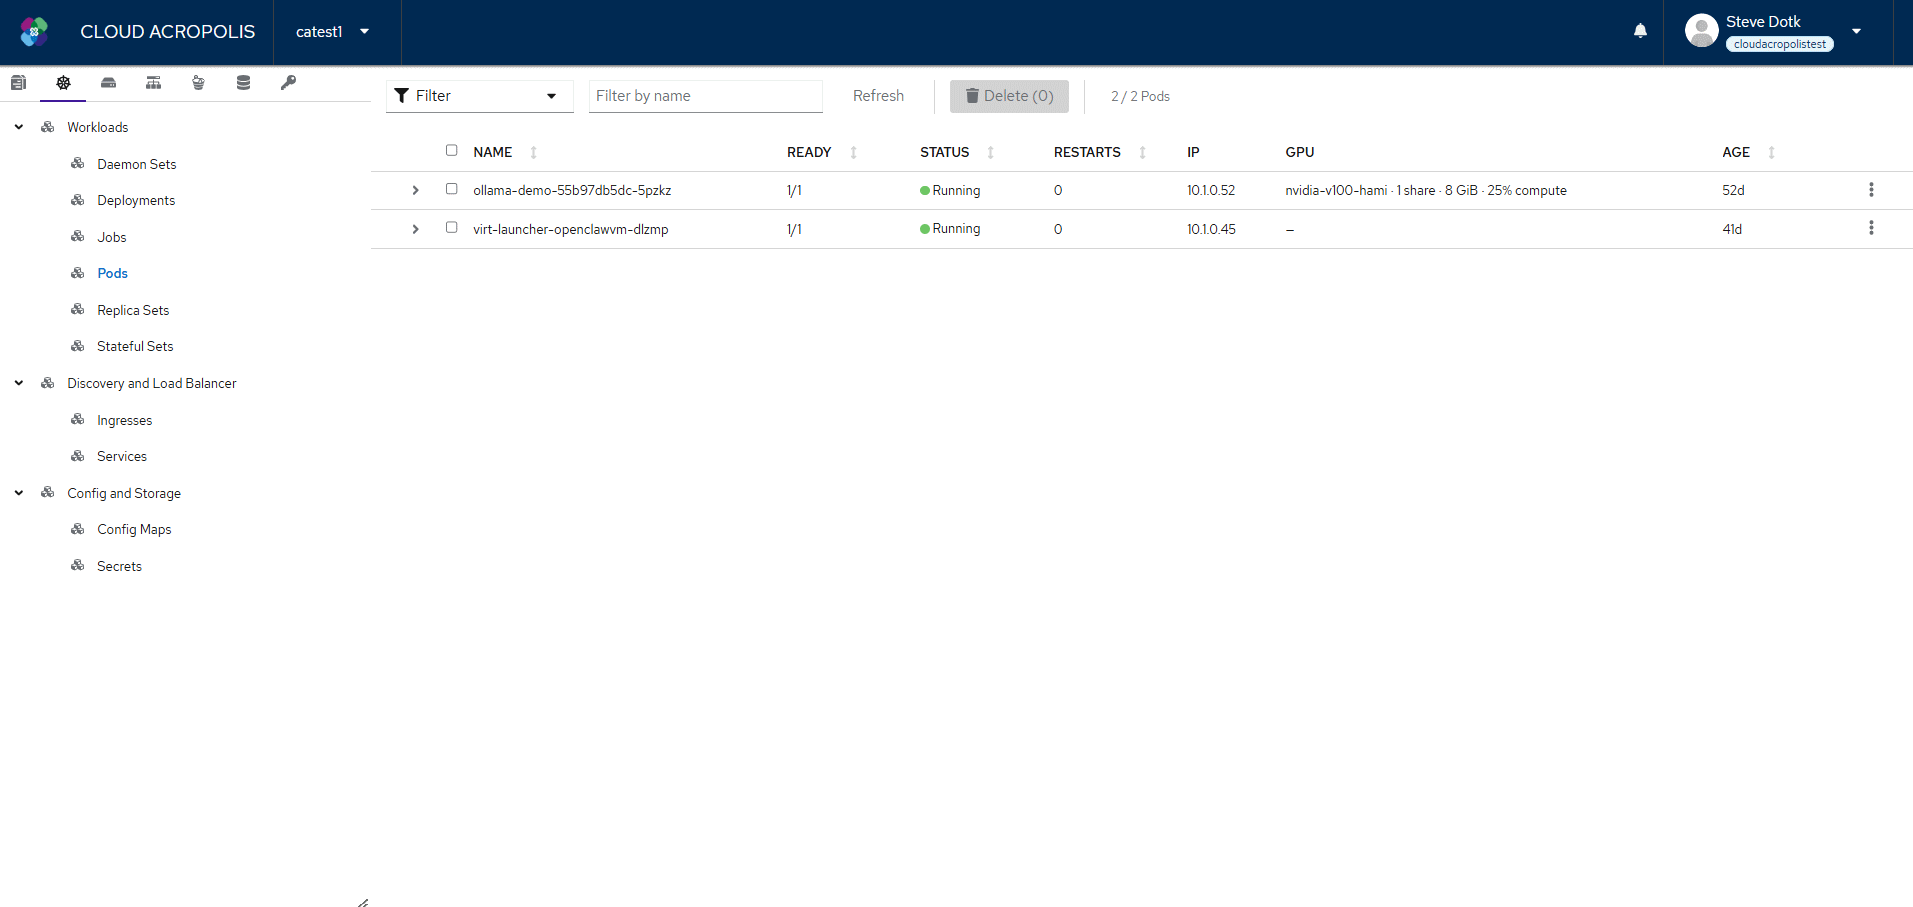
Legen Sie Autoscaling-Grenzen pro Worker-Pool fest und skalieren Sie Pods mit einem HorizontalPodAutoscaler. Der Metrics-Server ist in Managed Clusters vorinstalliert.
Auslastung
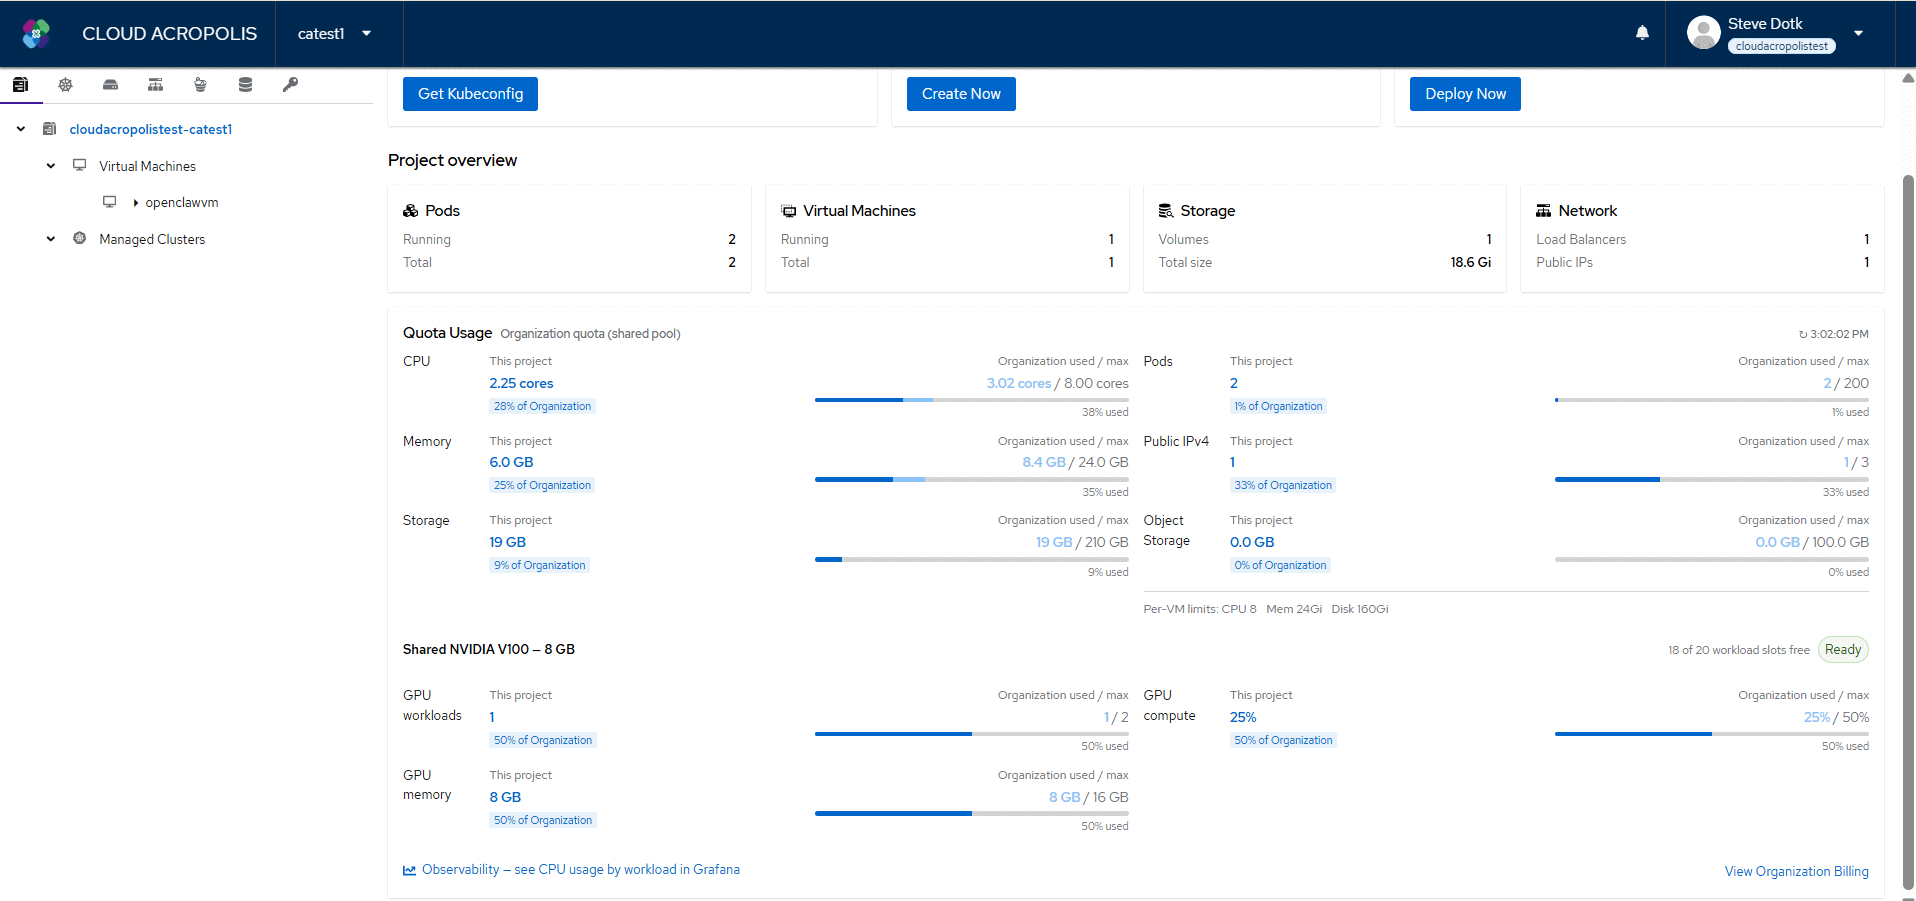
Teilen Sie Ihren Pool mit Quoten pro Projekt auf Teams auf und sehen Sie Quotenverbrauch, laufende Workloads und Netzwerkzuweisung in einer Ansicht.
Netzwerk
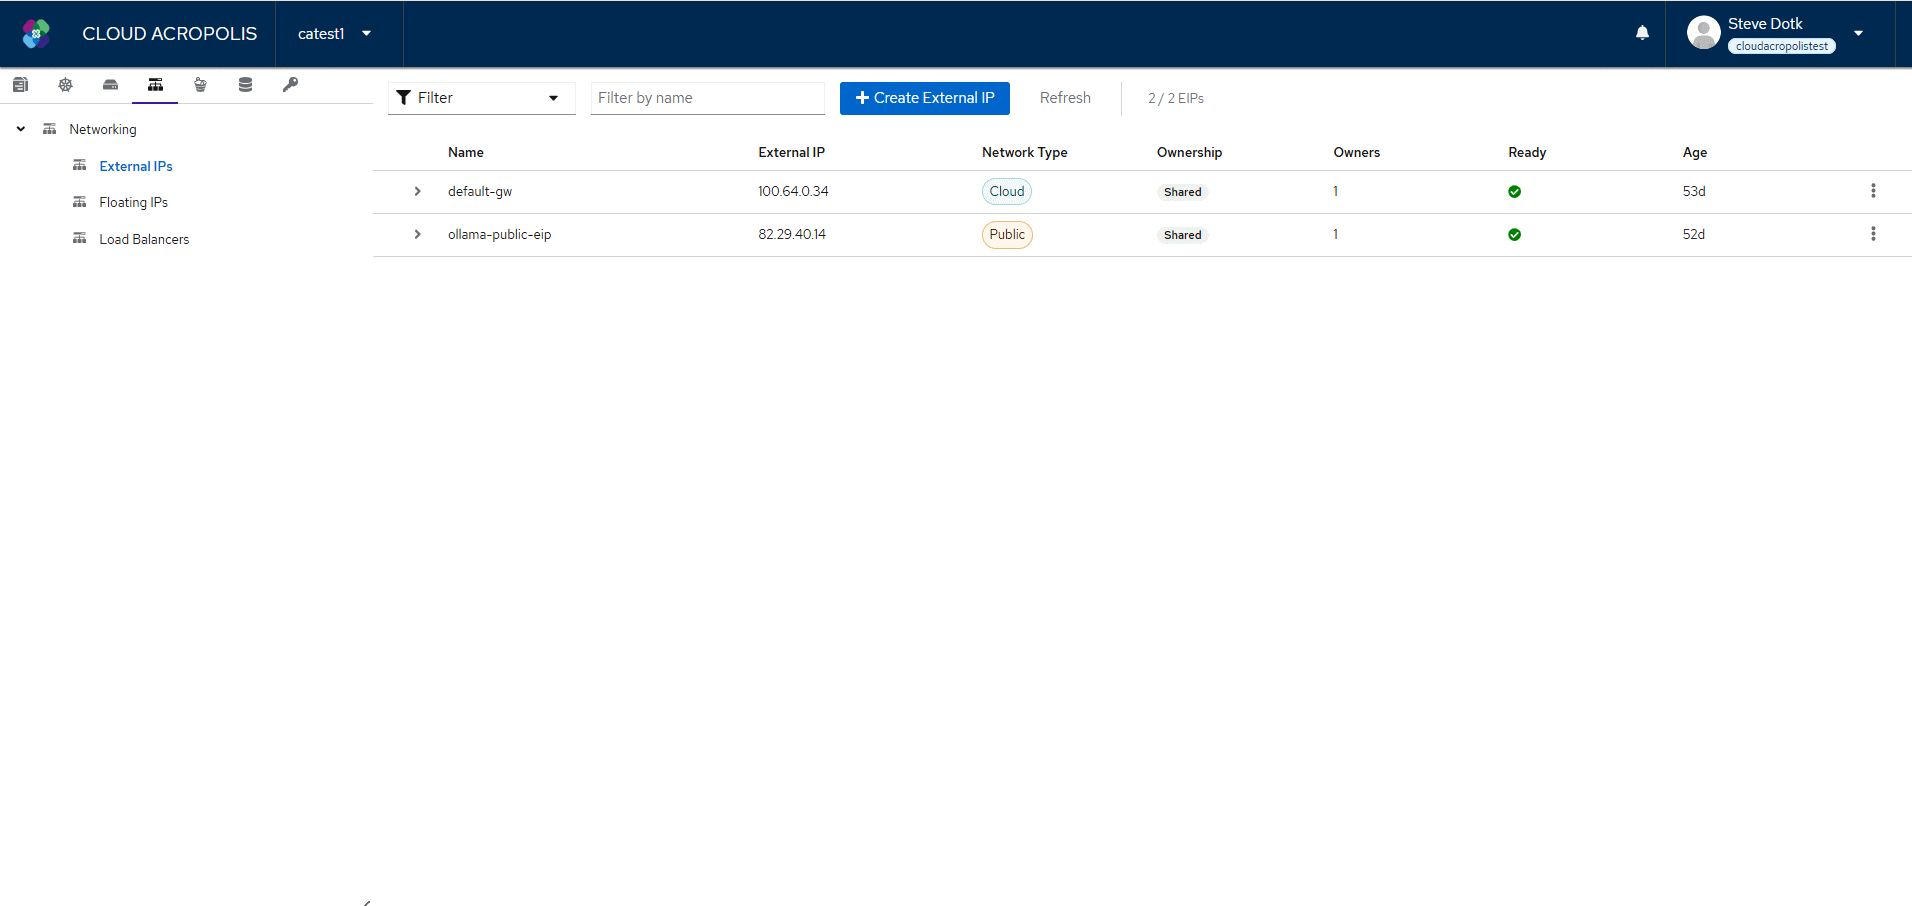
Jedes Projekt erhält ein eigenes VPC. Veröffentlichen Sie Workloads mit Load Balancern, einer dedizierten öffentlichen IPv4-Adresse und automatischem HTTPS.
Speicher
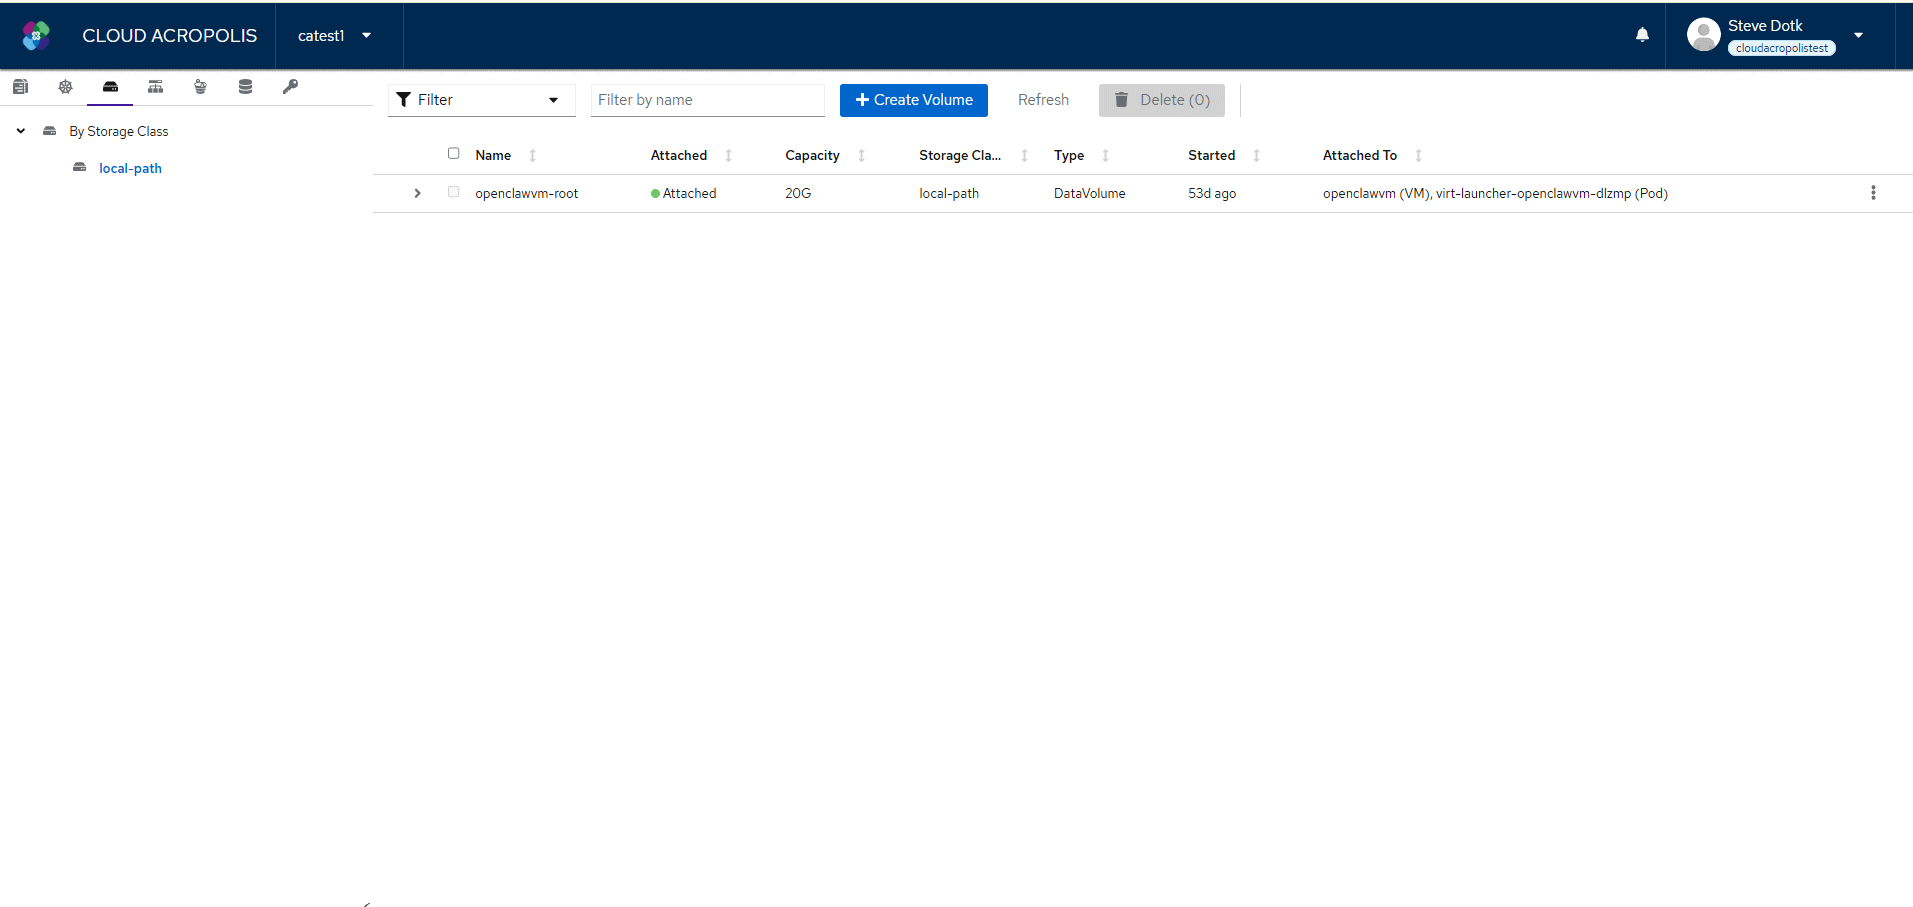
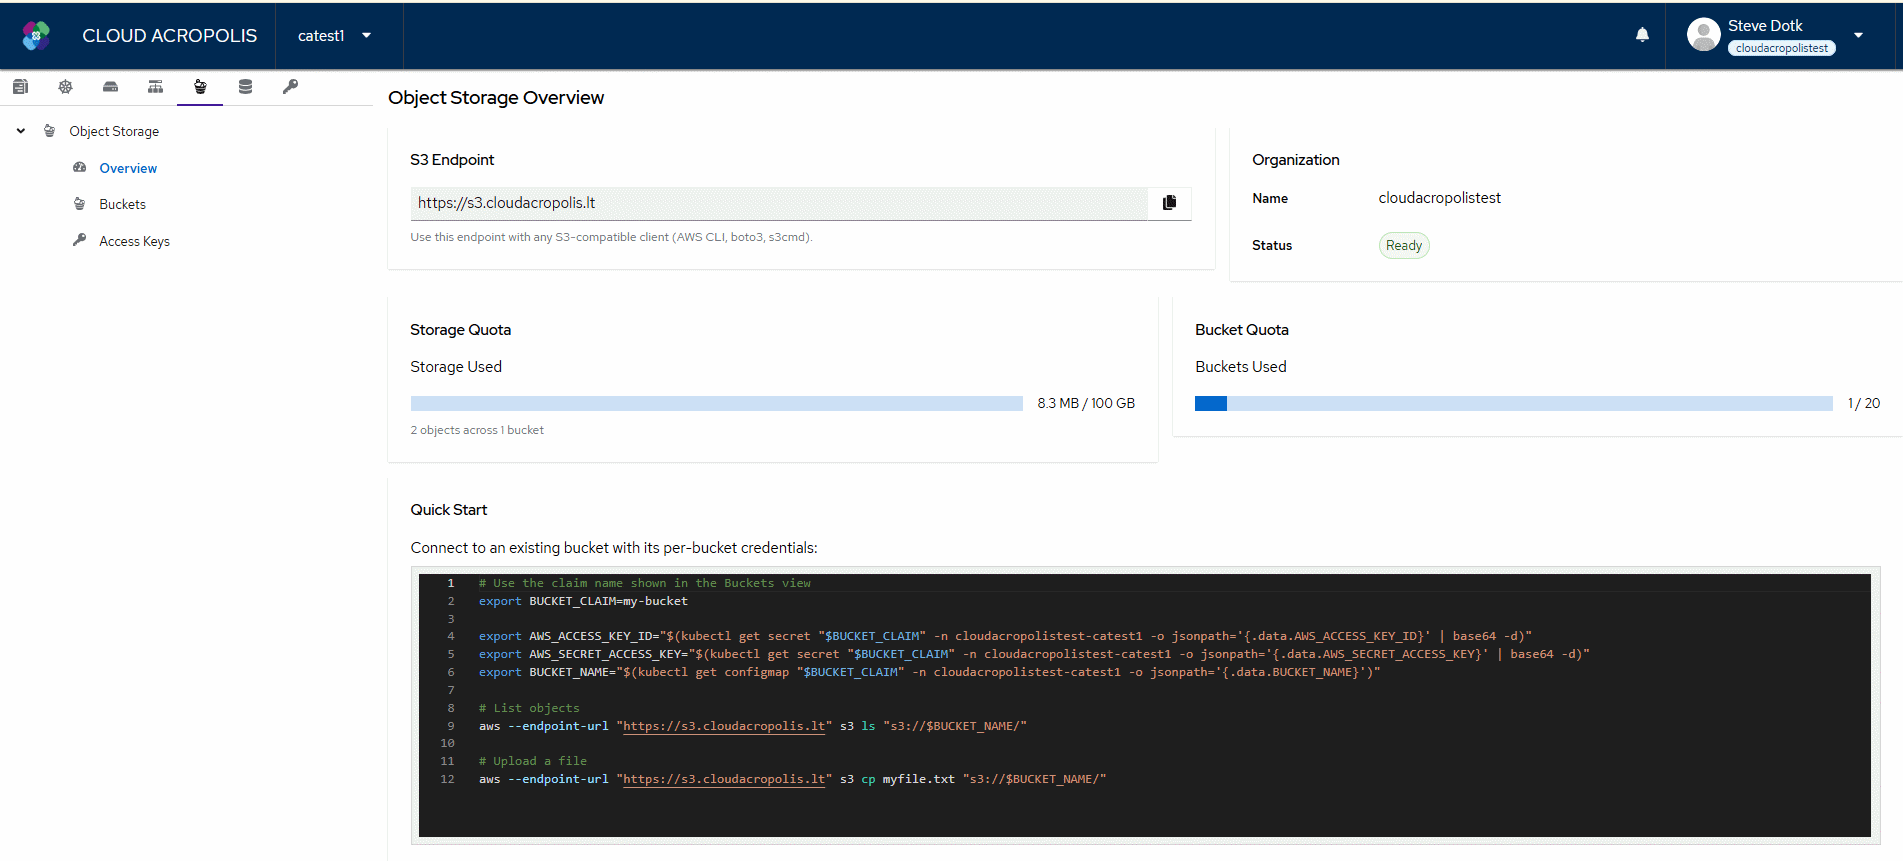
Persistente NVMe-Blockvolumes für Container und virtuelle Maschinen sowie S3-kompatibler Objektspeicher mit Ihren eigenen Zugangsdaten.
Deployen Sie direkt in ein Projekt mit dessen kubeconfig – ganz ohne vorherigen Cluster – oder betreiben Sie Linux- und Windows-VMs im selben Netzwerk wie Ihre Container. Helm, Terraform und GitOps-Tools funktionieren mit Ihrem Projekt.
Kubernetes Container Orchestration
Deploy containers that automatically scale, heal, and balance across your infrastructure
Container Orchestration
Automatically deploy and manage containers across nodesSelf-Healing
Failed containers are automatically replacedAuto Scaling
Scale pods up or down based on demandAlles, was Sie für die Container-Orchestrierung brauchen
Automatisierter Betrieb
Automatisierte Rollouts und Rollbacks sorgen für reibungslose Deployments und schnelle Wiederherstellung nach Fehlern.
Intelligente Verteilung
Integrierte Service Discovery und Lastverteilung für eine optimale Ressourcennutzung.
Enterprise-Speicher
Speicher-Orchestrierung auf Basis von Ceph für zuverlässige, persistente Datenspeicherung.
Automatische Wiederherstellung
Die automatische Wiederherstellung und der Austausch von Containern sorgen für Hochverfügbarkeit.
Sicherheit zuerst
Umfassendes Management von Secrets und Konfigurationen für sensible Daten.
Dynamische Skalierung
Horizontale Skalierung und Batch-Ausführung für eine optimale Ressourcennutzung.
Optimiertes Ressourcenmanagement
Schöpfen Sie das Potenzial Ihrer virtuellen Maschinen aus, indem Container automatisch auf die verfügbaren Ressourcen verteilt werden. Unsere Plattform verwaltet Ihre Ressourcen effizient und senkt unnötige Kosten, indem sie Ihre Anwendungen bei Bedarf dynamisch skaliert.
-
Automatisierte Container-Platzierung
-
Ressourcenoptimierung
-
Kosteneffiziente Skalierung
Vereinfachte Anwendungsbereitstellung
Die meisten Open-Source- und kommerziellen Anwendungen werden heute als Docker-Container oder Helm-Chart bereitgestellt und lassen sich mit einem einzigen Befehl auf Ihrem Kubernetes-Service ausrollen. Nutzen Sie unsere Managed-Private-Registry-Lösung, um Ihre eigenen Helm-Chart-Konfigurationsdateien und Container-Images zu hosten und zu importieren.
-
Deployments mit einem Klick
-
Unterstützung für Private Registries
-
Helm-Chart-Kompatibilität
Technische Spezifikationen
Unsere Plattform ist für Enterprise-Workloads gebaut
Infrastruktur
-
99,99 % Infrastrukturverfügbarkeit
-
3-Node-HA-Cluster mit dedizierten vCPUs
-
Hardware auf Enterprise-Niveau
-
Redundante Netzwerkinfrastruktur
Plattformfunktionen
-
Automatisierte Rollouts und Rollbacks
-
Integrierte Service Discovery
-
Lastverteilung
-
Selbstheilungsfunktionen
Sicherheit und Compliance
-
Rollenbasierte Zugriffskontrolle
-
Secret-Management
-
Netzwerkrichtlinien
-
Sicherheitsüberwachung
Bereit, Ihre Container bereitzustellen?
Ersparen Sie sich die Mühe, Ihre Kubernetes-Cluster selbst zu installieren und zu warten. Legen Sie noch heute los.